
攻击百分之95艰苦工作的机器学习
机器学习的工作量非常艰巨。尽管开源贡献解决了许多障碍,但一些最受炒作的机器学习框架只是略过要完成的工作的表面。是否存在一种可以使从数据摄取到训练再到边缘推理的庞大机器学习过程崩溃的技术?
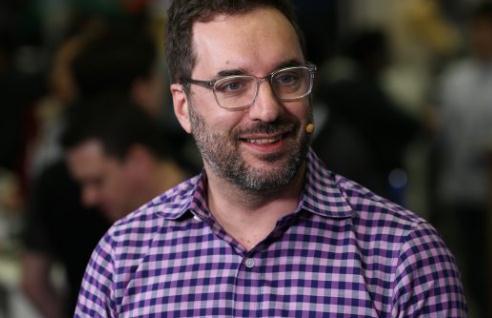
微软公司开源机器学习策略负责人David Aronchick(如图)表示,如今,越来越多的人选择正确的机器学习框架 。考虑到的框架包括 TensorFlow,Microsoft Cognitive Toolkit 和Apache MXNet。很少。它们远非无用之举-但它们可能还不能保证它们会引起所有关注。
“现实是,当您观察整体情况时,这只是普通数据科学家所完成工作的5%,” Aronchick说。他补充说,剩下的95%是一大堆生锈的螺母和螺栓,应该已经将其抽象掉。
这就是目标Kubeflow -用于部署和管理上的机器学习栈的开源项目Kubernetes,一个开源的平台,策划容器,用于运行分布式应用程序的虚拟化方法。
在最近于西雅图举行的KubeCon + CloudNativeCon会议上, Aronchick与John Furrier 和Stu Miniman ( SiliconANGLE Media的移动实时流媒体工作室)的联合主持人进行了交谈。他们讨论了开放源代码和学术界的烹饪方法,以缩短机器学习周期。
Kubernetes为数据科学家提供了期待已久的抽象层
我们今天要求数据科学家进行的艰巨工作将震惊更抽象的信息技术领域的许多人。“我们正在要求数据科学家,机器学习工程师考虑如何配置Pod,如何在驱动程序上工作,如何做所有这些非常非常低级的事情,” Aronchick说。
Aronchick相信学术研究人员将发现减少训练模型所需的数据量和劳动力的方法。但是,这可能无法解决所有数据传输问题。他补充说,跨多云环境的操作需要Kubernetes的抽象层。
他说:“现实是,您无法超越光速。” “如果我在这里有PB级的数据,将需要很长时间才能将其移到那里。我认为您最终将使模型,训练和推理移至许多不同的位置。”
Kubernetes和Kubeflow提供了高级抽象,因此数据科学家可以处理模型,查看其工作原理,按一下按钮并在所有必要的机器上进行配置。
不,Kubernetes不会像奶油干酪那样在Azure,Google Cloud Platform和Amazon Web Services Inc.上分发应用程序。“您真正想做的是将隔离部署部署到每个位置,使您只需一个按钮即可部署到所有这三个位置,” Aronchick说。
免责声明:本文由用户上传,与本网站立场无关。财经信息仅供读者参考,并不构成投资建议。投资者据此操作,风险自担。 如有侵权请联系删除!
-
【核心摘要】*选购硬件钱包,比价格更重要的三件事是:渠道是否官方授权、设备能否通过芯片级核验、服务是否坚...浏览全文>>
- 毛伟杰受伤恢复情况如何
- 李昊亚洲杯赛后评价内容是什么
- 李昊 5 次神扑拯救国足是哪场比赛
- 安洗莹对国羽女单影响有哪些
- 羽毛球亚运会安洗莹女单赛程是什么
- 韩国羽毛球女单安洗莹实力如何
- 中国跳水队解锁亚运百金了吗
- 跳水男子 10 米决赛时间是什么时候
- 中国跳水队亚运史有哪些亮点
- 中国剩余金牌预测依据有哪些
- 山口茜失利采访内容是什么
- 亚运会羽毛球项目赛程是怎样的
- 韩国犯规集锦内容是什么
- 亚足联裁判执法标准是什么
- 日媒骂张本智和是怎么回事
- 张本智和哭泣现场是哪场赛事
- 刘国梁首谈张本智和说了什么
- 张本智和月收入有多少
- 张玉宁手球慢镜头回放在哪看
- 毛伟杰伤退详情是什么